martedì 2 settembre 2014

Creazione personalizzati HttpClient gestori

Accesso alle API Web può essere fatto facilmente utilizzando il gestore HTTPClient. Questa classe accelera il processo di sviluppo di accedere ai dati da un Web API, e consente di personalizzare i gestori cliente in caso di necessità.
HTTPClient è un oggetto utilizzato per l'accesso di richiesta e risposta dei messaggi da e verso API web. Come chiamate client-server tradizionali, la HTTPClient chiama il server utilizzando uno specifico URI, aspetta il risultato, quindi restituisce un oggetto risposta al chiamante.

Come per tutto il resto nello sviluppo di software, la necessità finirà per sorgere per lo sviluppo personalizzato. Per fortuna, la classe HttpClient consente per questo. Un gestore di messaggi singolo, o un numero di gestori, possono essere creati e aggiunti in un ordine specifico per lo stack di chiamate utilizzando il metodo HttpClientFactory.Create.

Uno o più gestori di messaggi personalizzati possono essere creati e organizzati in una catena di gestori che vengono automaticamente chiamato con ogni richiesta e la risposta. Una volta creata la classe del gestore messaggio, esso può essere utilizzato per eseguire operazioni personalizzate durante la sequenza di chiamata. Osservando lo schema di figura 1 , la sequenza inizia con la richiesta del cliente, poi continua attraverso la catena di gestori. Una volta che il messaggio raggiunge il server, la risposta viene inviata indietro propagazione attraverso la catena dei gestori in ordine inverso.


Figura 1. Flusso dei messaggi per la richiesta del cliente e risposta
Per dimostrare i gestori personalizzati sul cliente, sarà necessaria una API Web per inviare richieste e ricevere risposte da. In un precedente articolo , ho dimostrato come è possibile creare un Web API. Il codice utilizzato in tale articolo servirà come l'API Web per questo articolo, con una piccola modifica. Nel metodo Registro della App_Start \ WebApiConfig.cs di file, aggiungerò la dichiarazione config.Formatters.Add (nuovo JsonMediaTypeFormatter ()) ;. Ciò consentirà l'API Web per formattare i dati di output in formato JSON. Si può vedere il codice completo in Listato 1 .

Listato 1: Contenuto del WebApiConfig.cs (in API Web di progetto) dopo la modifica
Pubblicità


utilizzando System.Net.Http.Formatting;
utilizzando System.Web.Http;

namespace CarInventory21
{
  pubblico WebApiConfig classe statica
  {
    public void Registro static (HttpConfiguration config)
    {
      // Configurazione e servizi Web API

      // percorsi API Web
      config.MapHttpAttributeRoutes ();

      config.Routes.MapHttpRoute (
        Nome: "DefaultApi",
        routeTemplate: "api / {comando} / {id}",
        default: nuovo {id = RouteParameter.Optional}
      );
      
      config.Formatters.Clear (); // Rimuovere tutti gli altri formattatori
      config.Formatters.Add (nuovo BsonMediaTypeFormatter ()); // Abilita BSON nel servizio Web
      config.Formatters.Add (nuovo JsonMediaTypeFormatter ());
    }
  }
}
Ora l'API Web è pronto per essere utilizzato con il nuovo demo applicazione client. Per questo, creerò una nuova applicazione Windows Form, come si vede in figura 2 .

 
[Clicca sull'immagine per ingrandirla.] Figura 2. Creazione di un'applicazione Windows Form come un client API Web
L'interfaccia utente per l'applicazione è mantenuto semplice per scopi dimostrativi, come si vede in Figura 3 L'applicazione client demo è destinato a funzionare da C:. \ WebAPI21ClientDemo.

 
[Clicca sull'immagine per ingrandirla.] Figura 3. ui per Web Demo Client API
Dopo aver impostato l'interfaccia utente in figura 3 , io aggiungo la classe Car ai frmMain.cs. La classe Car è un modello dei dati ricevuti dalla chiamata API web. E 'lo stesso modello utilizzato nel progetto Web API. Assicurarsi di aggiungere questo dopo la frmMain classe nello spazio dei nomi CarInventory21Client del file frmMain.cs. In caso contrario, verrà visualizzato un errore quando si tenta di visualizzare il form designer. Ecco la classe Car:

public class Auto
{
  pubblica Int32 ID {get; set; }
  pubblica Int32 Anno {get; set; }
  stringa di rendere pubblico {get; set; }
  stringa Modello pubblico {get; set; }
  public string colore {get; set; }
}
Avanti, creerò un nuovo gestore classe personalizzata denominata CustomHandlerA, come si è visto in Listato 2 . Questa classe sarà anche nello spazio dei nomi CarInventory21Client del file frmMain.cs, ma al di sotto della classe frmMain. Vi spiegherò il motivo di questo più tardi.

Listing 2: La classe CustomHandlerA 
Classe CustomHandlerA: DelegatingHandler
{
  CustomHandlerA pubblico ()
  {
  }
     
  protected override async Task <HttpResponseMessage> SendAsync (HttpRequestMessage richiesta, 
    CancellationToken CancellationToken)
  {
    // Aggiungere funzionalità personalizzate qui, prima o dopo base.SendAsync ()
    WriteLog ("CustomHandlerA () - prima handler interno");
    HttpResponseMessage risposta = attendere base.SendAsync (richiesta, CancellationToken);
    WriteLog ("CustomHandlerA () - dopo handler interno; response.StatusCode =" + 
      response.StatusCode);

    ritorno di risposta;
  }

  WriteLog public void (string msg)
  {
    StreamWriter sw = new StreamWriter ("C: \\ WebAPI21ClientDemo \\ LogFile.txt", true);
    sw.WriteLine (DateTime.Now.ToString () + "" + Msg);
    sw.Close ();
  }
}
La funzionalità di questa classe è minimo e mantenuto semplice per scopi dimostrativi. Il gestore registra semplicemente un messaggio in un file di log prima e dopo la chiamata al metodo base.SendAsync. Questi messaggi vengono registrati in un file di testo utilizzando il metodo WriteLog.

Per dimostrare la sequenza di chiamate utilizzando più gestori personalizzati durante una chiamata API Web, sarò anche creare CustomHandlerB. Questa classe avrà la stessa funzionalità CustomHandlerA, ma verrà utilizzata per dimostrare la sequenza di chiamate da un gestore ad un altro.

Una volta completato, i frmMain.cs file conterrà quattro classi utilizzate in questo esempio:

frmMain: classe per Windows Forms funzionalità
Auto: modello di dati utilizzato per de-serializzare i dati ricevuti
CustomHandlerA: classe di handler HttpClient personalizzato
CustomHandlerB: classe per abitudine HttpClient gestore
Tutte le classi saranno nello spazio dei nomi CarInventory21Client. In genere, l'ordine degli oggetti all'interno di un file è irrilevante. Tuttavia, in un'applicazione Windows Form, l'errore in figura 4 viene rilevato se la classe Windows Form non è la prima classe della lista.

 
[Clicca sull'immagine per ingrandirla.] Figura 4. Errore Grazie al modulo di classe non essere primo nel file
L'errore si legge: "Il frmMain classe può essere progettato, ma non è la prima classe nel file di Visual Studio richiede che i progettisti utilizzano la prima classe nel file Spostare il codice della classe in modo che sia la prima classe nel file e provare.. caricare di nuovo il progettista. " Per risolvere questo errore, spostare semplicemente la classe del form alla parte superiore dello spazio dei nomi.

Guardando la classe CustomHandlerA più in dettaglio, prima che sarà ereditato da System.Net.Http.DelegatingHandler. La classe DelegatingHandler è un tipo di base per gestori HTTP, delegando l'elaborazione dei messaggi di risposta HTTP a un altro gestore, noto come il "gestore interiore." Per saperne di più su questa classe, vedere la pagina di MSDN Library, " DelegatingHandler classe . "

Una volta che la classe DelegatingHandler viene ereditata, il metodo SendAsync può essere ignorato. Questo sarà il metodo per eseguire codice personalizzato, prima o dopo la chiamata al gestore interno (base.SendAsync). Il base.SendAsync è il metodo che invia la richiesta al successivo gestore della catena.

Guardando il codice del gestore eventi per btnGet_Click nel Listato 3 , prima della firma del metodo è stato modificato per restituire in modo asincrono, utilizzando la parola chiave "async".

Listato 3: btnGetClick da frmMain.cs 
privato async vuoto btnGet_Click (object sender, EventArgs e)
{
  CustomHandlerA Cha = new CustomHandlerA ();
  CustomHandlerB CHB = new CustomHandlerB ();
  HttpClient client = HttpClientFactory.Create (CHA, CHB);

  client.BaseAddress = new Uri ("http: // localhost: 15324 /");
  client.DefaultRequestHeaders.Accept.Clear ();
  client.DefaultRequestHeaders.Accept.Add (
    nuovo MediaTypeWithQualityHeaderValue ("application / json"));
            
  HttpResponseMessage risposta = attendere client.GetAsync ("api / auto");
  se (response.IsSuccessStatusCode)
  {
    Auto [] = myCarArray attendono response.Content.ReadAsAsync <Auto []> ();
    foreach (myCar auto in myCarArray)
    {
      txtResults.AppendText (string.Format ("{0} \ t {1} \ t {2} \ n \ n", myCar.Id, myCar.Make, 
        myCar.Model));
    }                    
  }   
}
Successivamente, vengono istanziati istanze del CustomHandlerA e CustomHandlerB. Tali istanze vengono poi utilizzati durante la creazione di un oggetto HttpClient. Passando istanze dei gestori personalizzati per il metodo Create, Sono la creazione di un oggetto client con uno specifico ordine di delegare gestori. I prossimi tre istruzioni nel codice impostare URI e il tipo di formattazione JSON Media.

Dopo le proprietà richieste dell'oggetto client sono impostate, la chiamata client.GetAsync viene eseguito. Questo restituisce un oggetto HttpResponseMessage contenente i dati richiesti in formato JSON. I dati possono poi essere analizzati dall'oggetto response.Content. I risultati verranno visualizzati nella finestra dell'applicazione, come mostrato nella Figura 5 .

 
[Clicca sull'immagine per ingrandirla.] Figura 5. risultati visualizzati dopo aver chiamato il Web API
Guardando il contenuto del file di log (LogFile.txt), visto in qui, vedrete l'ordine di esecuzione:

2014/06/12 12:07:52 CustomHandlerA () - prima handler interno
2014/06/12 12:07:52 CustomHandlerB () - prima handler interno
2014/06/12 12:07:52 CustomHandlerB () - dopo handler interno; response.StatusCode = OK
2014/06/12 12:07:52 CustomHandlerA () - dopo handler interno; response.StatusCode = OK

venerdì 29 agosto 2014

Migrazione da Subversion a Git con svn2git su Windows (bit difficili spiegati)

Questo è uno di quei "Continuo a fare questo e mi fa male ogni volta e non c'è mai una buona risorsa concisa che spiega bene così sto scrivendo un" messaggi. Sì, sì, lo so che è facile - se si è installato Ruby. Oppure stai vivendo in un mondo * nix. O avete una ragionevole comprensione di Git. Oppure si ottiene piacere dal dolore.
Tuttavia, se stai vivendo su Windows e si desidera solo per ottenere il dannato fatto, può essere doloroso. Continuo la creazione di nuove macchine e dover ricordare come farlo da zero in modo da questo momento , sto scrivendo tutto verso il basso. Qui geos:

1) Installare Rubino

Sì, Ruby. Vai farla da Installer per Windows Rubino pagina e installare l'ultima versione con tutte le impostazioni predefinite - tranne questo:
Il programma di installazione di Ruby per Windows
Prendi il file eseguibile di Ruby aggiunto alla variabile d'ambiente PATH in modo che è possibile eseguire da qualsiasi punto (più sul perché presto).Avrete probabilmente bisogno di un riavvio per tale dichiarazione PATH a calci in troppo.
Perché Ruby? Perché svn2git è scritto su di esso in modo che non stai andando lontano fino ad avere questo correre.

2) Installare la gemma svn2git

Se gemme sono un concetto estraneo, sono i pacchetti NuGet del mondo di Ruby. È possibile prendere la gemma svn2git direttamente dalla riga di comando, basta accendere una finestra di comando ed eseguire questo (il percorso si esegue da non importa se hai aggiunto la dichiarazione PATH per il passaggio precedente):
gem install svn2git
Poi attendere che la magia accada:
Installazione del svn2git rubino gemma
Questo è svn2git ora installato. Nel caso foste curiosi, la gemma finisce diffusione fuori attraverso il vostro percorso di installazione di Ruby:
attività svn2git nella cartella di Ruby

3) Migrare il repository Subversion

E, naturalmente, ciò che tutti noi venuti qui per, in primo luogo - di pompaggio che repository Subversion in Git. Fare riferimento alla pagina del progetto su GitHub svn2git per l'utilizzo o dargli un po 'di "svn2git -h", mentre nella finestra di comando sul sentiero sopra. A seconda della configurazione, è possibile trovare è necessario fornire esplicitamente le credenziali quando si esegue questo comando in modo da considerare che.In breve, però, stiamo andando a puntare lo strumento ad una distanza repository Subversion e ottenere per creare un locale repository Git.
Per l'amor di esempio, ho intenzione di eseguire questo in una nuova cartella locale ho creato in c: \ MyProject:
http svn2git: // [nome del dominio] / svn / [root repository]
Dopo che tutte le corse, avrete un repository Git completo con tutto il codice e la cronologia delle revisioni nella cartella c: \ MyProject percorso.Vai avanti e utilizzare il vostro client preferito Git e controllare la cronologia commit - sembra familiare? Dovrebbe.
Un Gotcha qui e per il bene di Googleability, ripeto l'errore si può vedere:
Comando non riuscito:
git checkout -f maestro
Questo è ciò che accade quando si punta svn2git in un percorso sotto la radice del repository, come "tronco". E 'facile da fare in quanto è probabilmente il tronco si è verificato a livello locale e, se farete ciò che io faccio e ricevo intorno copiare e incollare link, è molto facile fare questo e mi chiedo cosa sta succedendo. Controlla il tuo percorso!

4) Spingere il repository da qualche parte utile (come GitHub)

Giusto per chiudere il ciclo del flusso di lavoro che molte persone passare attraverso, sarete spesso finiscono per voler prendere il vostro nuovo repository lucido e colpire fino a qualche parte come GitHub. Ho un repository demo vuoto che sembra proprio come questo:
Una nuova repository su GitHub
Vado a prendere l'URL del repository (è laggiù verso il basso a destra nell'immagine sopra) e aggiungerlo come un remoto :
git add remota origine https://github.com/troyhunt/MyProject.git
Proprio come un controllo di integrità, darò un po 'di "-v remoto git" per confermare che è completato con successo:
Aggiunta di un remoto git
Ora cerchiamo di spingere tutti i rami locali fino a GitHub
git push -all
Il che ci dà:
Risultato dopo aver spinto a GitHub
E abbiamo finito! Facciamo sanità mentale controllare che su GitHub:
GitHub mostrando 32 commit
32 commit - c'è la vostra storia!

Incartare


Questa è una visione volutamente semplicistica che intenzionalmente non tocca su una serie di varie questioni, ma è tutto su come ottenere installato e funzionante come facilmente possibile.

martedì 26 agosto 2014

InfoSec Insanity: Condividere la pazza per il miglioramento della sicurezza online

Ero un po 'stufo con la follia Continuavo a vedere sul web quando si tratta di sicurezza, così ho creato questo:
Logo
Proprio così, un grande grande lucchetto freakin 'con una camicia di forza o più al punto, ho creato l'account Twitter InfoSecInsanity .
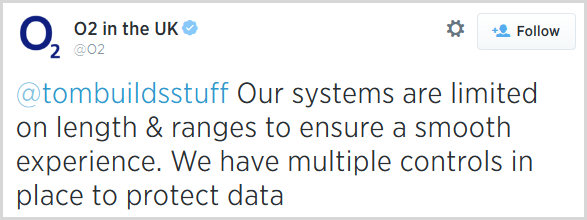
Così che cosa esattamente è InfoSec Insanity? Ci prendiamo questo esempio dal weekend sulla limitazione password che era il catalizzatore per la creazione del conto:
tombuildsstuff I nostri sistemi sono limitati alla durata e gamme per garantire un'esperienza liscia.  Abbiamo più controlli in atto per proteggere i dati
Oh, così quando O2 ha deciso di smettere di voi da mettere in un bel password, casuale era per il tuo bene! Beh, io sono contento che abbiamo chiarito che fino.
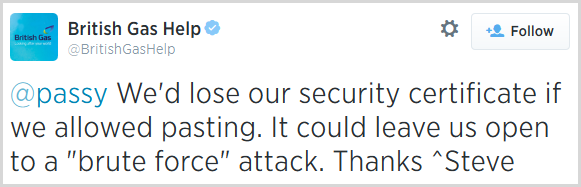
Ecco un altro favorito, questa volta da British Gas all'inizio di quest'anno. Preoccupato per la mancanza di capacità di incollare in creds da un gestore di password, un preoccupato Twitterer parlato di questo e ha ottenuto un, uh, la risposta "impressionante":
passy avremmo perso il certificato di sicurezza se permettessimo incollare.  Potrebbe lasciarci aperto ad un attacco di "forza bruta".  Grazie ^ Steve
Ora io non so cosa Steveo fumava qui, ma credo che non era legale.
Tweets Nutty sono una cosa e con tutti i mezzi, sono esattamente il tipo di cosa che ho intenzione di essere la condivisione da questo account, ma cerchiamo di non fermarsi qui. Uno dei miei preferiti era recenti questo post ho scritto su Stack Overflow risposte alla domanda di crittografia della password . Il primo convenuto serio per la (ora cancellato) domanda condiviso molte righe di codice che accuratamente dimostrato come utilizzare Base64 - no, non per codificare la cifra risultante, ma come l'unico mezzo di offuscamento credenziale . Altri carillon con schemi di rotazione dei caratteri fondamentali Due - prendere "a" e sostituirlo con "f" poi "b" e sostituirlo con "g" e così via e così via.
Quindi, ecco la "chiamata alle armi" per così dire:
Tweet link ad approcci di sicurezza pazzo o le risposte del processo dado di conti di social media e avrò InfoSecInsanity per dare loro un grido-out. Menzione troyhunt o InfoSecInsanity con un link alla pagina o un Tweet e sarà guadagnare un punto sulla timeline.
Evitiamo il "Questi ragazzi appena inviato via email la mia password" o "Quei ragazzi non mi lascia usare le virgolette nel mio password" genere di cose perché come muto come è, saremmo qui tutto il giorno e inondano la timeline con loro. Sono molto interessato e la roba che ci fa veramente andiamo "WTF, dici sul serio?!?!». Sarà tenerlo più interessante per i seguaci.

L'ultima cosa di un breve "cappello di punta" per trasgressori testo normale e il recente vergogna HTTP . Entrambi questi siti fanno un grande lavoro di gridare follia INFOSEC nelle rispettive aree (siti di e-mail le credenziali e quelli che non l'attuazione di un livello di trasporto sicuro dove richiesto). Il "naming and shaming" incoraggiano va in qualche modo a tenere i siti che esercitano pratiche ingannevoli rendere conto e che hanno fornito ispirazione per InfoSec Insanity.

venerdì 1 agosto 2014

Kinect for Windows SDK Preview in Motion

Ora che Kinect per Windows 2.0 i dispositivi hanno spedito, in anteprima il kit di sviluppo software è disponibile per più di sviluppatori di giochi.
Il Kinect per team di Windows ha rilasciato una preview del suo Kinect per kit di sviluppo software 2.0 di Windows all'inizio di questo mese. L'anteprima ha coinciso con il rilascio di Kinect per i sensori di Windows 2.0, un dispositivo che viene rivolto a sviluppatori commerciali che vogliono aggiungere la voce, il gesto, e le caratteristiche di movimento per applicazioni business e consumer per la vendita attraverso il Windows Store.
Il Kinect for Windows SDK anteprima migliora le caratteristiche di orientamento scheletrici, con un aumento del numero di persone che possono seguire (6) e le articolazioni scheletriche si può tracciare per persona (25), bagarini un blog da Kinect per team di Windows. Il blog cita anche il supporto per la piattaforma cross-sviluppo, compreso il supporto per la piattaforma di sviluppo di gioco Unity. L'SDK ha anche una funzione che permette uno sviluppo senza la necessità di un sensore presente Kinect, così come un costruttore gesto personalizzato.Inoltre è migliorata face tracking, catturando i tratti del viso con un aspetto più realistico.
Il Kinect for Windows SDK 2.0 può essere scaricato qui .
Il dispositivo Kinect per Windows 2.0 se stesso come stato migliorato, con più raffinata orientamento scheletrico, 1080p supporto video HD, e nuove funzionalità infrarossi attivi. È US $ 199, e può essere acquistato qui o in alcune punti vendita.
Per gli sviluppatori che hanno appena nello sviluppo di Kinect, Microsoft consiglia "di programmazione per Kinect per 2.0 di Windows Jumpstart" Certo, disponibile tramite il Microsoft Virtual Academy qui .

lunedì 28 luglio 2014

Microsoft incoraggia Oracle migrazioni a SQL Server 2014

Microsoft ha presentato ieri un aggiornamento di SQL Server Migration Assistant (SSMA) per facilitare lo spostamento dei database Oracle esistenti per SQL Server 2014 .

E 'l'ultimo sforzo avanti e indietro tra le due aziende per aiutare gli utenti dei prodotti RDBMS concorrenti passare alla propria offerta di ogni società.

Lo strumento gratuito SSMA è stato annunciato sul blog TechNet SQL Server.

"Disponibile ora, la versione SSMA 6.0 per i database Oracle semplifica notevolmente il processo di migrazione di database da database Oracle a SQL Server", ha detto Microsoft. "SSMA automatizza tutti gli aspetti della migrazione, compresa l'analisi valutazione della migrazione, lo schema e la conversione un'istruzione SQL, la migrazione dei dati, nonché le prove di migrazione per ridurre i costi e ridurre i rischi di progetti di migrazione di database."

SQL Server 2014 - ufficialmente rilasciato nel mese di aprile - presenta un nuovo, tanto pubblicizzata capacità OLTP in memoria , e il nuovo SSMA per Oracle può muoversi automaticamente tabelle Oracle in SQL Server 2014 tabelle in memoria. Microsoft ha detto SSMA in grado di elaborare fino a 10.000 oggetti Oracle in una migrazione e vanta incrementare le prestazioni e la generazione di report.

Il nuovo strumento supporta migrazioni di database Oracle 9i e poi a SQL Server 2005, edizioni e versioni successive. E 'ora disponibile per il download .

Oltre alla capacità di memoria OLTP, SQL Server 2014 funzioni in memoria columnstore per aumentare le prestazioni delle query e ibridi funzionalità cloud-correlati, come la possibilità di eseguire il backup nel cloud direttamente da SQL Server Management Studio. Microsoft ha inoltre sollecitato la sua capacità di utilizzare il Microsoft Azure il cloud come un sito di disaster recovery utilizzando SQL Server 2014 AlwaysOn. SQL Server 2014 è disponibile per la valutazione .


lunedì 21 luglio 2014

Sfruttando l'utente Modelli mentali di creare efficaci interfacce utente

I principi di grande design dell'interfaccia utente partono da un luogo diverso rispetto dei principi che portano al grande design dell'applicazione. Entrambi finiscono esattamente nello stesso posto, però.

By Peter Vogel2014/07/18

Ammettilo: Se la vostra stanza è fredda e il termostato è impostato per la temperatura più alta che si desidera, si accende il termostato più in alto, non è vero? Lo facciamo perché tutti abbiamo questo modello mentale di termostati che è organizzato attorno "realizzazione" - crediamo che se chiediamo solo nostro forno per fare un po 'di più di quanto vogliamo, quindi il forno ci arriva a quello che vogliamo, più veloce. E 'lo stesso modello mentale vostro capo usa quando si dà una scadenza impossibile ("stirata"): Un termine impossibile ti farà lavorare di più e, forse, incontrare il vero termine che il vostro capo è mantenere da voi.

Come funzionano le cose
, ma non è questo il modo in cui il termostato effettivamente funziona (e probabilmente non è il modo di lavorare, sia, ma il tuo capo non lo sa). Il termostato accende il forno su e lascia via fino a raggiungere la temperatura desiderata ... e poi il termostato dà completamente, chiudendo il forno spento. Il termostato non ottiene il forno a lavorare di più per arrivare a una temperatura, si ottiene solo il forno a lavorare più a lungo . Impostazione del termostato più alto non si fa arrivare alla temperatura desiderata più velocemente. Nel nostro cuore sappiamo che, naturalmente, ma abbiamo impostato la temperatura più alta, comunque. (Detto questo: io capisco che ci fosse un modello di Cadillac che ha funzionato in questo modo in modo che, come hai più vicino alla temperatura desiderata, la ventola che soffia aria calda rallentato Ma quella era l'eccezione, non la regola. , quindi per favore non portarlo nei commenti. prego).

Ora diamo un'occhiata al calendario. Come pensate del vostro programma? Pensi di esso come un elenco ordinato di eventi? Oppure, come molte persone fanno, pensi di vostro programma come un insieme di secchi (Lunedi, Martedì, Mercoledì e così via) con un numero limitato di slot (09:00, 09:30, 10:00 e così via) che può essere riempito? Sotto il cofano, ovviamente, Outlook probabilmente non mantenere il vostro calendario come un elenco ordinato di eventi (che è il motivo per cui si possono avere due eventi programmati per lo stesso tempo) ... ma che non è come voi, o la maggior parte delle altre persone, pensate. Probabilmente avete Outlook configurato per visualizzare la pianificazione utilizzando il modello di benna / fessura, per esempio.

Pubblicità

Un ultimo esempio: Probabilmente pensiamo dei quadranti sulla nostra frigoriferi controllo del "freddo" del frigorifero ottiene quando, in effetti, i quadranti sul controllo del frigorifero quanto calore viene rimosso dal frigorifero. Queste discrepanze tra la nostra comprensione e ciò che sta realmente accadendo, non sono sempre un problema - lo scollamento tra il nostro modello mentale per il nostro frigorifero e il meccanismo di fondo cade in una zona "nessun danno, nessun fallo", per esempio.

Tuttavia, Don Norman, nel suo meraviglioso libro, " La caffettiera del masochista ", parla di tentativo di controllare la temperatura del suo frigorifero freezer quando la disconnessione importava. Il frigorifero aveva due quadranti e Norman presume che una linea controllava la freddezza della parte principale del frigorifero, mentre l'altro quadrante controllava la freddezza del freezer. Egli era in grado di impostare la temperatura interna del congelatore per quello che voleva fino a quando non si rese conto che aveva frainteso come i quadranti lavorati. Si è scoperto che una linea controllata la temperatura globale del frigorifero e l'altra linea controllata come quella fredda è stato distribuito tra il congelatore e il corpo principale del frigorifero. Con questo nuovo modello mentale, Norman è stato finalmente in grado di gestire la temperatura del suo frigorifero. O ha comprato un frigorifero che corrispondeva il suo modello mentale ... non ricordo quale.

Abbinamento Modelli ... e mancanza
Ovviamente, quindi, il modello mentale di un'applicazione e il modello mentale dell'utente devono raggiungere una certa comprensione - anche se, come Outlook e il "nessun danno, nessun fallo" modello per la gestione dei frigoriferi dimostrano, i due non hanno identici. Ma, come ho suggerito in articoli precedenti , tutto dipende da chi sono i vostri utenti siano. Non ci sono regole dure e veloci nel design dell'interfaccia utente.

Ad esempio, pensate della vostra stufa ha muniti di una fonte di riscaldamento centralizzato che è possibile indirizzare ad un luogo o in un altro (fuochi, forno)? Probabilmente no. Ma se si possiede un fornello Aga, si sta andando a correre in problemi reali, se non si pensa in quel modo, perché più o meno, è così che funziona un fornello Aga.

E non fare l'errore di pensare questi esempi non sono correlati alla programmazione: come sviluppatore, avete a che fare con i modelli mentali degli utenti per tutto il tempo. Ad esempio, avete le tabelle del database create per sostenere l'integrità referenziale, il che significa, per esempio, che è necessario aggiungere una riga al vostro tavolo SalesOrderHeader prima di poter aggiungere una riga al vostro tavolo SalesOrderDetail. Tuttavia, i clienti probabilmente pensano delle cose che vogliono acquistare (le righe SalesOrderDetail) prima di pensare a come vogliono avere l'ordinanza (la riga SalesOrderHeader). Costruire un'applicazione che richiede all'utente di fornire informazioni sulla consegna e poi cercare di giustificare che il design per l'utente facendo riferimento alla "integrità referenziale" non è andare a lavorare (non chiedetemi come lo so questo). Dovrete scrivere l'applicazione per rendere il lavoro mentale del modello dell'utente: i dati della prima, intestazioni tardi.

E se non si ottiene mentale giusto modello dell'utente, le cose brutte accadono alle buone aziende. Ho lavorato per una società che ha fatto di gomma specialità. Siamo stati, di fatto, nel settore carta da parati: Quando si esegue fuori di carta da parati a metà una stanza, non si torna a comprare "più wallpaper" - si torna indietro e comprate più dello stesso disegno. Probabilmente torna al negozio hai il primo lotto da e anche cercare di ottenere di più da parati dallo stesso lotto della tintura come sfondo originale. Questo è stato il modello mentale clienti della mia azienda seguirono ei nostri sistemi sono stati istituiti per supportare tale modello mentale.

La mia azienda ha ottenuto acquistata da un'altra azienda che ha fatto della gomma di merce: Era più come vendere le viti di carta da parati. Quando si esegue fuori di viti non avete bisogno di una corrispondenza esatta delle viti che hai usato prima; a comprare di più, probabilmente si va al negozio di ferramenta più conveniente a vostra disposizione. Questo è stato il modello mentale dei suoi clienti e questo è ciò che le applicazioni aziendali sono stati istituiti a sostegno.

La mia azienda commutato ai sistemi software della nuova società ed è stato un incubo. I nostri clienti esistenti sarebbero richiamare, cercando più gomma da un specifico lotto di gomma. Per trovare quella partita, i nostri utenti sono stati ridotti a scorrere i record di produzione cercando di trovare il lotto e quindi correlando le informazioni di produzione con record di inventario, al fine di trovare dove è stato memorizzato tale partita. E mentre i nostri utenti che hanno fatto, i nostri clienti hanno aspettato (con impazienza) al telefono.

Perché Designing Interfaces Matter
Il modello mentale utente potrebbe significare che la scrittura di una singola applicazione potrebbe non essere possibile. Se stai progettando un servizio per aiutare la gente va a vedere un film, ci sono almeno due diversi modelli mentali avresti bisogno di prendere in considerazione. Se si sta sostenendo un fanatico di film, è necessario supportare la ricerca su filmati specifici e fare progetti su come vedere quel film - forse anche un viaggio in un'altra città per farlo. Oppure si potrebbe essere sostenendo spettatori occasionali: qualcuno che decide di andare a vedere un film e poi controlla per vedere ciò che è disponibile. Questi due diversi modelli mentali stanno andando a richiedere due applicazioni diverse.

E non sono solo gli utenti che influenzano l'interfaccia: Dipende anche su storie degli utenti. Quando stavo parlando il calendario e affermando che si pensa ad esso come una serie di secchi e non come un elenco ordinato, c'era probabilmente una voce nella tua testa dicendo: "Aspetta un minuto! A volte penso del mio programma come elenco ordinato: `Devo fare questo, allora devo fare questo, allora ho .... '" E questo è vero: Nel breve periodo (il "cosa devo fare adesso" storia dell'utente), si fa spesso pensare al vostro programma come un elenco ordinato di eventi si deve lavorare.

Tutto questo è il motivo per cui, naturalmente, Outlook consente di guardare il vostro programma come un elenco di eventi e perché a volte utilizzare tale impianto. Si può capire perché il libro di Norman era originariamente chiamata "La psicologia del masochista ".

Che cosa fare (e non fare) dovete fare
così, ancora una volta, ti sto chiedendo di strisciare dentro la testa dei vostri personaggi, questa volta per capire come gli utenti pensano il problema si sta cercando di aiutarli con . Il vostro compito è quello di decidere come l'interfaccia utente esprimerà quel modello mentale per gli utenti.

Sei libero, ovviamente, per presentare agli utenti un, migliore modello mentale più recente per affrontare il problema (come il frigorifero di Norman). Se lo fai, il vostro compito è quello di rendere quel modello chiaro per gli utenti nell'interfaccia utente e, inoltre, hanno l'interfaccia utente dimostrare una ragione convincente per cui l'utente deve cambiare il loro modello mentale. Frigorifero di Norman ha fatto nessuno dei due.

Con ogni probabilità, ci saranno differenze tra il modo in cui l'interfaccia utente presenta il problema e il modo in cui l'applicazione "realmente" funziona. Il tuo prossimo lavoro è quello di colmare questa lacuna con il codice.

Ma come programmatore, che è quello che si dovrebbe fare comunque: L '"io" e "D" delle massime codice SOLID riferimento ai principi Interface segregazione e dipendenza inversione. Nel loro insieme, un modo di guardare a questi due principi è che le interfacce nostre classi espongono dovrebbero essere progettati per il cliente che utilizza tali classi. Le nostre interfacce di classe dovranno esprimere il modo in cui il cliente vuole lavorare e per semplificare la vita del cliente. L'interfaccia non dovrebbe essere una semplice espressione degli algoritmi o strutture di tabelle che la classe incapsula sottostanti.

Quindi davvero non importa se si sta progettando un utente o un'interfaccia di classe: è il design per rendere la vita più facile per il cliente e per abbinare il modo in cui i clienti vogliono risolvere i loro problemi. L'algoritmo sottostante può funzionare in un modo completamente diverso ... ma questo non importa. Si scrive il codice per tradurre tra l'apparenza e la realtà. Questo è il tuo lavoro.

Ehi, siamo i programmatori! Siamo in grado di far funzionare nulla.
Corso Visual Studio - Corso asp.net
Corso C# - Corso PHP - Corso Joomla - Corsi asp.net - Corso Java

giovedì 17 luglio 2014

Come di refactoring per Dependency Injection, Parte 3: applicazioni di grandi dimensioni

Ondrej Balas continua la sua serie sul refactoring del codice per l'iniezione di dipendenza, concentrandosi sulle tecniche che rendono più facile refactoring di applicazioni complesse.

Con Ondrej Balas2014/07/16

Dependency Injection è un paradigma di programmazione che consente di scrivere codice molto più gestibile attraverso la promozione di accoppiamento lasco di oggetti. (Nel caso in cui li hai persi, questo articolo è una continuazione della Parte 1 e Parte 2 nella mia serie sulla dependency injection.) In una nuova o piccola applicazione, refactoring di Dependency Injection è relativamente semplice. Poiché l'applicazione di essere riorganizzata cresce più grande, tuttavia, può diventare piuttosto l'impresa. Fortunatamente, c'è un modo per semplificare il problema e refactoring tuo pezzo applicazione per pezzo.

Refactoring un'applicazione complessa
Prima di iniziare il refactoring, è necessario sapere che cosa cercare. Sono una persona molto visiva, così ogni volta che mi occupo di refactoring di un grande o complessa applicazione, comincio da lavagna tutte le componenti e le loro interazioni. Vedendo tutti i progetti sul tavolo mi permette di vedere facilmente dove il punto di ingresso nell'applicazione è, che è dove voglio mettere la mia Composizione Root.

Ho poi passo attraverso il codice, entrando in ogni costruttore, e cerco costruttori che nuovi oggetti in se stessi, come questo:

NotificationEngine pubblico ()
{
  _dataStream = new SomeDataStream ();
  _emailSender = new EmailSender ();
  . _recipientAddress = new ConfigurationReader () GetNotificationRecipientAddress ();
  _logger = new FileSystemLogger ("somepath.txt");
}
Quando vedo questo, è quasi garantito gli oggetti che vengono creati qui hanno i loro costruttori proprio come questo, creando una complessa catena di costruttori. E se questo non bastasse, gli oggetti sono probabilmente anche creati in altri luoghi, rendendo le cose ancora più confuse.

Come ho già detto in precedenza nella serie, l'obiettivo è quello di sostituire eventualmente costruttori come quella con i costruttori che prendono le loro dipendenze come parametri anziché crearli, come questo:

Pubblicità

NotificationEngine pubblico (IDataStream Datastream, IEmailSender EmailSender,
  IConfigurationReader configurationReader, ILogger logger)
{
  _dataStream = Datastream;
  _emailSender = EmailSender;
  _recipientAddress = configurationReader.GetNotificationRecipientAddress ();
  _logger = logger;
}
In un'applicazione complessa, questo è molto più facile a dirsi che a farsi. Una pietra comune passo è quello di creare la nuova costruzione, ma lasciare il costruttore predefinito originale al suo posto. Il costruttore originale deve quindi essere modificato per mettere in nuova costruzione, come questo:

NotificationEngine pubblico ()
    : Questa (nuova SomeDataStream (),
    nuovo EmailSender (),
    nuovo ConfigurationReader (),
    nuovo FileSystemLogger ("somepath.txt"))
  {
  }
Non interrompere qualsiasi codice esistente consente di refactoring dell'applicazione un pezzo alla volta. E quando si utilizza un Dependency Injection (DI) container per creare gli oggetti, la maggior parte dei contenitori selezionerà automaticamente il costruttore più complicata, piuttosto che quella di default (ne parleremo più avanti).

Questa tecnica, nota come "Bastard Injection," è controverso e generalmente considerato un anti-modello. Questo è perché è spesso usato solo come un modo per facilitare il test di unità, mentre i costruttori di default sono ancora gli unici costruttori utilizzati nel codice di produzione. Può anche causare il codice per creare implicitamente dipendenze assembly che non sarebbero altrimenti dovrebbe essere di riferimento. Ad esempio, se IEmailSender era un'interfaccia definita nello stesso progetto come costruttore, ma non era EmailSender, creando la EmailSender all'interno del costruttore creerebbe una dipendenza su tale altro gruppo.

Eppure, trovo Bastard iniezione di un ripiego incredibilmente utile in pratica - ma non dovrebbe essere l'obiettivo finale.

Una volta ho completato un primo passaggio attraverso l'applicazione, mi metto alla ricerca del "nuovo" parola chiave utilizzata in altri luoghi. Un'altra cosa comune che vedo è campi che hanno le nuove implementazioni dato a loro e nessun costruttore presente, come questo:

public class NotificationEngine
{
  readonly privato IDataStream _dataStream = new SomeDataStream ();
  readonly privato IEmailSender _emailSender = new EmailSender ();
  . stringa readonly privato _recipientAddress = new ConfigurationReader () GetNotificationRecipientAddress ();
  readonly privato ILogger _logger = new FileSystemLogger ("somepath.txt");
   
  / / Il resto della classe
}
Questo dovrebbe essere riscritta come se tutti gli oggetti di istanze stava avvenendo all'interno del costruttore predefinito.

Iniezione Setter
Finora ho usato Constructor Injection, che è di gran lunga la forma più comunemente usata di DI. A seconda dello scenario, altri modelli potrebbero essere più efficaci. Un tale modello, Iniezione Setter (noto anche come Injection proprietà), è utile quando c'è un default ragionevole e locale per la dipendenza da impostare. Prendete il codice in Listato 1 , per esempio.

Listato 1: Un'implementazione di iniezione Setter utilizzando gli attributi Ninject
privato IEmailSender EmailSender;
[Inject, Optional]
pubblico IEmailSender EmailSender
{
  ottenere
  {
    if (EmailSender == null)
    {
      EmailSender = new DefaultEmailSender ();
    }
    ritorno EmailSender;
  }
  set {EmailSender = value; }
}
Anziché impostare la proprietà EmailSender all'interno del costruttore, è etichettato con il Inject e gli attributi opzionali. L'attributo Inject dice Ninject per impostare subito che la proprietà dopo aver creato l'oggetto, ma che, da sola, potrebbe non essere sufficiente. Se l'attributo opzionale non è impostato anche, Ninject sarà un'eccezione se non c'è presente vincolante per IEmailSender. Grazie alla combinazione di entrambi gli attributi, è possibile creare una proprietà che è impostato solo se esiste un legame - altrimenti, verrà utilizzata la DefaultEmailSender.

Gestione di più Costruttori
Quando si tratta di più costruttori, è importante sapere quale sarà chiamato dal contenitore DI quando un oggetto del richiesto. Questo varia leggermente da contenitore a contenitore, ma il principio generale è che il contenitore utilizzerà il costruttore con il maggior numero di parametri può risolvere completamente. Ad esempio, si supponga di avere tre costruttori:

1: public Quirble ()
2: public Quirble (IFoo foo)
3: public Quirble (IFoo foo, bar IBar)
Se il contenitore ha solo vincolante per IFoo, ma non IBar, selezionerà costruttore No. 2. Se ha un legame sia IFoo e IBar, selezionerà costruttore No. 3. Se non ha né vincolante, selezionerà il costruttore predefinito (n. 1). Con Ninject, è possibile forzare un costruttore specifico per essere chiamato utilizzando l'attributo Inject:

1: [Inject] Quirble pubblico ()
Utilizzando l'attributo Inject, che stai dicendo Ninject usare sempre quel costruttore e ignorare tutti gli altri costruttori.

Ci sono alcuni casi particolari in cui alcuni contenitori non comportano lo stesso come gli altri. Prendete questo esempio:

1: public Quirble (IFoo foo)
2: public Quirble (IBar bar)
In questo caso, se il contenitore ha un legame sia per IFoo e IBar, Ninject genererà un'eccezione a causa di un costruttore ambigua. Nella stessa situazione, Castello di Windsor selezionerà uno dei costruttori. In realtà, secondo la sua documentazione , "Se ci sono più di un costruttore più golosi, si utilizzerà qualsiasi di essi. È indefinito che uno e non si deve dipendere da Windsor raccogliendo sempre lo stesso."

Scomposizione
Rifattorizzare un'applicazione complessa per utilizzare l'iniezione di dipendenza può sembrare complicata, ma con tecniche come Bastard iniezione può essere suddiviso in tante piccole refactoring. È inoltre possibile utilizzare tecniche come l'iniezione setter in luoghi dove il passaggio ad iniezione del costruttore sarà difficile. E sappiate che i contenitori differenti si comportano in modi diversi, quindi, quando you'e non so come si comporterà il contenitore, è sempre una buona idea di controllare la documentazione.

Up next: configurazione XML, uno sguardo a vari contenitori DI e come creare una architettura plug-in con l'uso del legame basato convenzione.
Corso Visual Studio - Corso asp.net
Corso C# - Corso PHP - Corso Joomla - Corsi asp.net - Corso Java